Desenvolvimento de LLM privados dentro da sua rede

LLM à medida sobre modelos abertos, afinados com os seus dados e nos seus servidores, sem que nada saia da sua rede.

LLM privados que implementamos

As seis configurações que mais entregamos, e qualquer outra que as suas regras sobre dados exijam.

  1. 01 / 06

    LLM on-premise e isolados

    Modelos abertos nos seus próprios servidores, sem ligação à internet quando as suas regras o exigem.

    • Servidores com GPU dimensionados e instalados no seu centro de dados
    • Instalações isoladas, com modelos e atualizações trazidos sem ligação
    • Sem ligação a serviços de IA externos
    • Atrás da sua firewall e do seu início de sessão único
  2. 02 / 06

    LLM em cloud privada

    Modelos servidos a partir da sua própria conta na cloud, na região onde os seus dados têm de ficar.

    • Na sua própria conta e rede na cloud, não nas nossas
    • Na região onde os seus dados têm de ficar
    • Endpoints privados, sem caminho público até ao modelo
    • GPU que aumentam e diminuem com a procura
  3. 03 / 06

    Híbrido: modelos privados e alojados

    Um modelo privado para o trabalho sensível e de grande volume, e um modelo alojado de fronteira só para o que faz melhor.

    • Cada pedido encaminhado conforme os dados que leva
    • Os dados sensíveis, sempre no modelo privado
    • Um modelo alojado para o raciocínio mais difícil, onde for permitido
    • Uma só API para as suas aplicações, seja qual for o modelo que responde
  4. 04 / 06

    Modelos afinados e à medida

    Modelos abertos adaptados aos seus documentos, termos e formatos, e modelos pequenos treinados para uma só tarefa.

    • Fine-tuning com LoRA sobre os seus próprios exemplos
    • Modelos pequenos para uma tarefa, mais baratos de manter
    • Mais treino com os seus próprios textos quando compensa
    • Pontuado face ao modelo base antes de ser publicado
  5. 05 / 06

    RAG, assistentes e agentes privados

    Pesquisa em documentos, assistentes e agentes de IA construídos sobre o modelo privado, para que os seus dados nunca saiam da sua rede.

    • Respostas com os seus documentos, citando as fontes
    • Assistentes para equipas jurídicas, financeiras, de RH e de suporte
    • Agentes que atuam nos seus sistemas com o modelo privado
    • O mesmo início de sessão e as mesmas permissões das suas ferramentas
  6. 06 / 06

    Em funcionamento, vigiado e atualizado

    O modelo rápido, acessível e atualizado depois do lançamento, com cada pedido registado.

    • Desempenho, latência e carga das GPU monitorizados
    • Quantização e processamento em lote afinados para reduzir custos
    • Os novos modelos abertos testados antes de substituírem os atuais
    • Registos de utilização e de auditoria para cada equipa

O nosso processo de desenvolvimento de LLM privados

Seis passos, desde o que o modelo tem de fazer até um modelo que a sua equipa usa todos os dias no seu próprio hardware.

  1. 01Âmbito

    Os seus casos de uso, dados e conformidade, e o que custa face a uma API alojada.

  2. 02Planeamento

    Modelos abertos testados com os seus casos e um escolhido, com o hardware dimensionado nas suas instalações ou numa cloud privada.

  3. 03Desenvolvimento

    Fine-tuning ou recuperação onde compensa, e ligado às suas aplicações.

  4. 04Testes

    Precisão, latência e alucinações medidas, com os controlos de acesso e auditoria verificados.

  5. 05Lançamento

    Servido atrás do seu próprio gateway, com início de sessão único e monitorização.

  6. 06Manutenção

    Atualizações do modelo, patches e prevenção, ou uma passagem para a sua própria equipa.

Funcionalidades dos LLM privados

O que integramos num modelo privado, ajustado a onde corre e a quem o usa.

  • Isolamento de rede

    Sem chamadas a serviços de IA externos: prompts, ficheiros e respostas ficam na infraestrutura que controla.

  • Uma API padrão que as suas apps já entendem

    Um endpoint compatível com a OpenAI, para que ferramentas e código mudem trocando só um endereço.

  • Início de sessão único e funções

    Entra-se com o seu início de sessão único, e cada equipa chega só aos modelos e dados que lhe cabem.

  • Registo de auditoria

    Quem perguntou o quê, quando e que modelo respondeu, num registo que é seu.

  • Limites de uso por equipa

    Quotas de pedidos e tokens por equipa ou app, para que uma carga não deixe as outras sem recursos.

  • Ajustado ao seu hardware

    Modelos quantizados e agrupados para caber nas suas GPU, sem descer abaixo da fasquia de qualidade.

  • Novas comparações de modelos

    Cada novo modelo aberto é avaliado com os seus casos, e só entra se ganhar.

  • Monitorização e alertas

    Débito, latência, erros e carga de GPU acompanhados, com alertas antes de os utilizadores notarem.

  • Testes de red team

    Injeção de prompts, fugas de dados e regras de acesso testadas antes do lançamento e após cada alteração.

Como começar

Algo novo com IA, ou IA no software que já tem.

Algo novo

Software que já tem

Setores para os quais desenvolvemos software

Desenvolvimento de software à medida para cada setor: web, móvel e IA, construído e auditado em segurança pela mesma equipa.

  • Um quarto de hospital moderno ao fim do dia, com a cama feita junto a um monitor de doente e um suporte de soro

    Saúde e MedTech

    Desenvolvimento de software médico e de saúde: portais do doente, apps de telemedicina, integração com o processo clínico e painéis clínicos.

  • Um telemóvel com uma app bancária aberta ao lado de um cartão de pagamento metálico preto numa mesa de pedra

    Fintech e pagamentos

    Desenvolvimento de apps fintech e de pagamentos: gateways de pagamento, carteiras digitais, banca móvel e plataformas de crédito.

  • Uma loja de streetwear com uma parede de hoodies e camisolas desportivas, um expositor iluminado de sapatilhas e um balcão de terrazzo com t-shirts e bonés

    Retalho e ecommerce

    Desenvolvimento de lojas online e ecommerce: apps de compras, software de ponto de venda e gestão de inventário.

  • Um carrinho de bagagem em latão com malas e um casaco no átrio de um hotel moderno, junto à receção

    Viagens e hotelaria

    Software de viagens e hotelaria: apps de viagens, motores de reservas, gestão hoteleira (PMS) e integração com fornecedores.

  • Uma linha de montagem robotizada numa fábrica inteligente, com braços robóticos em células de vidro e robôs autónomos a transportar peças

    IA e automação

    Desenvolvimento de IA e automação: agentes de IA, chatbots, processamento de documentos e fluxos de trabalho automatizados.

  • O estúdio de uma equipa de software, com um roteiro de notas autocolantes num quadro branco sobre uma mesa partilhada

    SaaS e marketplaces

    Desenvolvimento de software SaaS e marketplaces: plataformas multiempresa, subscrições, perfis de utilizador e pagamentos a vendedores.

  • Encomendas num tapete transportador de um armazém de distribuição, com racks altos de paletes e um empilhador atrás

    Logística e cadeia de abastecimento

    Software de logística e transportes: gestão de frotas, sistemas de gestão de armazém (WMS), planeamento de rotas e seguimento de envios.

  • O átrio de uma biblioteca universitária com mesas de estudo, salas de estudo envidraçadas e uma sala de gravação sob vários pisos de estantes

    Educação e EdTech

    Desenvolvimento de plataformas de ensino e EdTech: sistemas LMS, plataformas e-learning, salas de aula virtuais e avaliações.

  • Uma porta de vidro com leitor de impressões digitais junto a um longo corredor de racks de servidores num centro de dados

    Cibersegurança

    Software de cibersegurança: gestão de identidades e acessos, painéis SIEM e ferramentas de conformidade, além de auditorias de segurança e testes de intrusão.

  • A sala e a cozinha de um apartamento novo ao fim do dia, com janelas do chão ao teto para torres residenciais e uma grua

    Imobiliário e PropTech

    Software imobiliário e PropTech: portais imobiliários, CRM imobiliário, gestão de arrendamentos e apps para inquilinos.

  • A biblioteca de pé-direito duplo de um escritório de advogados ao anoitecer, com uma longa mesa de nogueira preparada com um contrato, uma caneta de tinta permanente e dossiês

    Jurídico e LegalTech

    Software jurídico para escritórios de advogados e equipas jurídicas: gestão de processos e contratos, gestão documental e eDiscovery.

  • Uma arena de esports antes de uma final, um mapa de batalha de fantasia no ecrã gigante sobre duas mesas de equipa iluminadas e uma taça de prata num pedestal

    Gaming e esports

    Software para esports e gaming: backends de jogos, emparelhamento multijogador, plataformas de torneios, contas de jogador e pagamentos dentro do jogo.

Também desenvolvemos software para seguros (insurtech), administração pública (govtech), energia e media. Se o seu setor não estiver na lista, também podemos desenvolver software para ele.

Software que temos em produção

Três produtos próprios, desenhados, construídos e mantidos pela equipa que implementaria o seu LLM privado.

  • Retalho · SaaS

    Um sistema de ponto de venda que reúne vendas, inventário e talões no terminal, no tablet e no telemóvel.

    Captura de ecrã, 1908 × 944
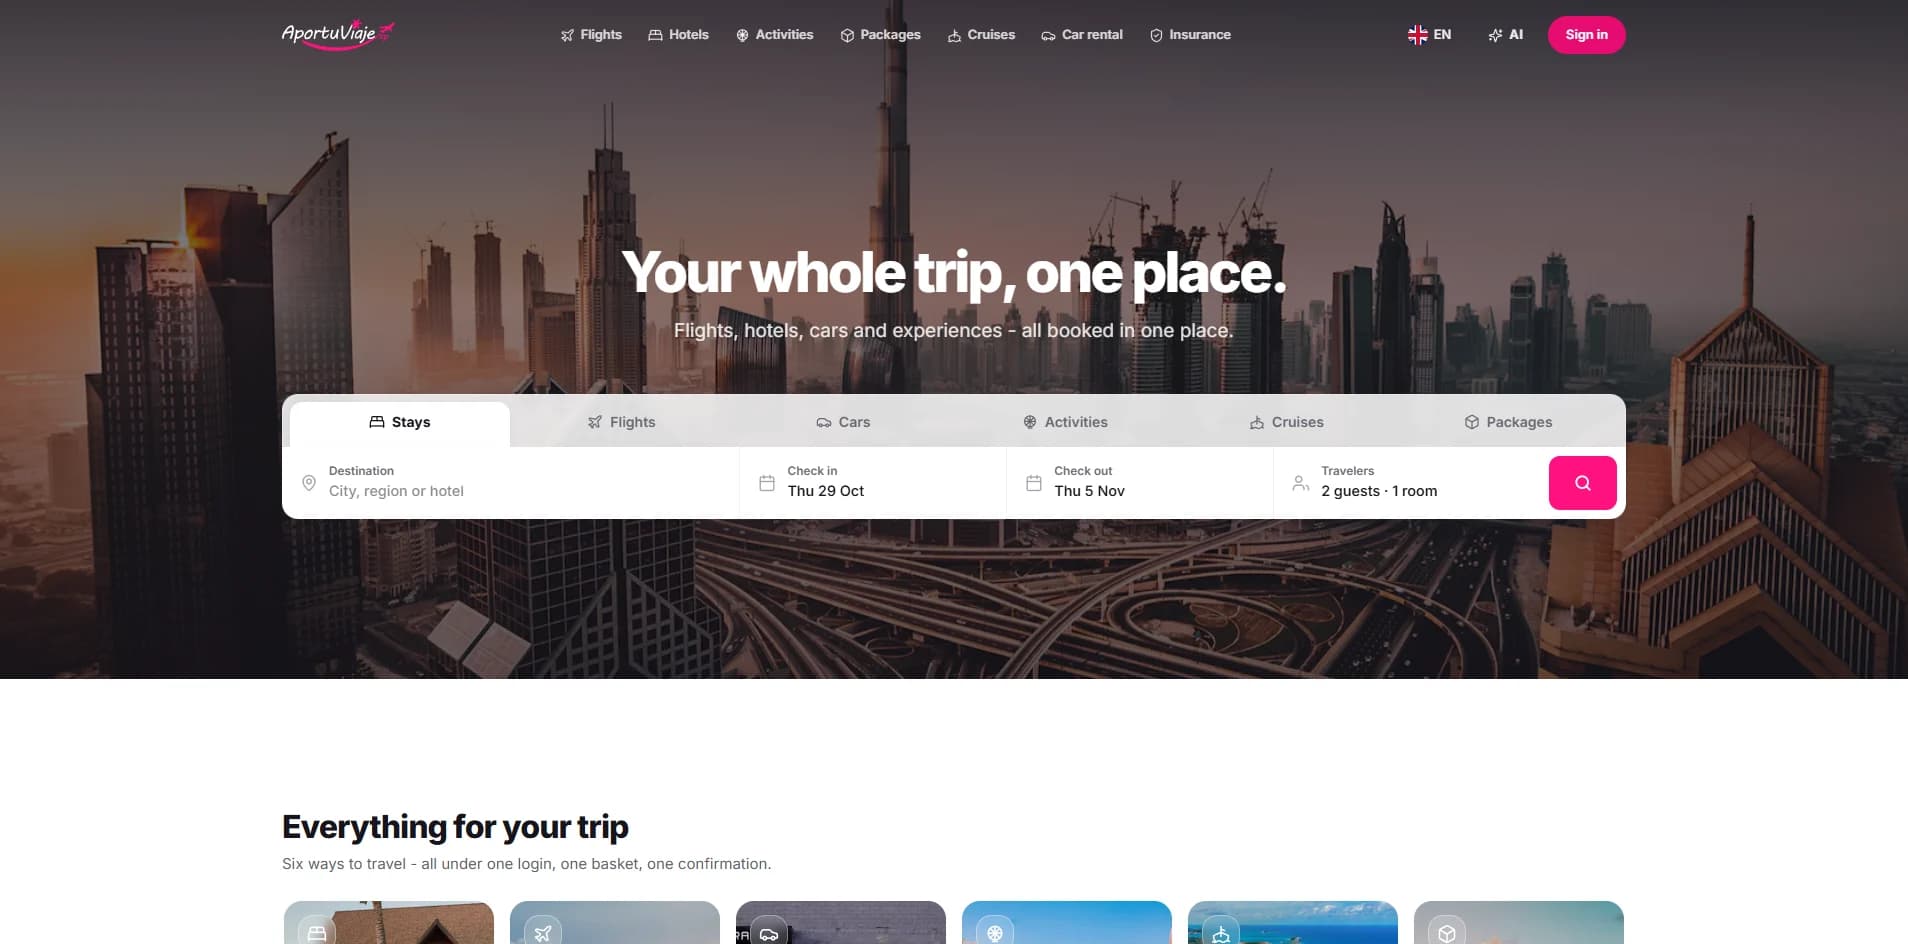
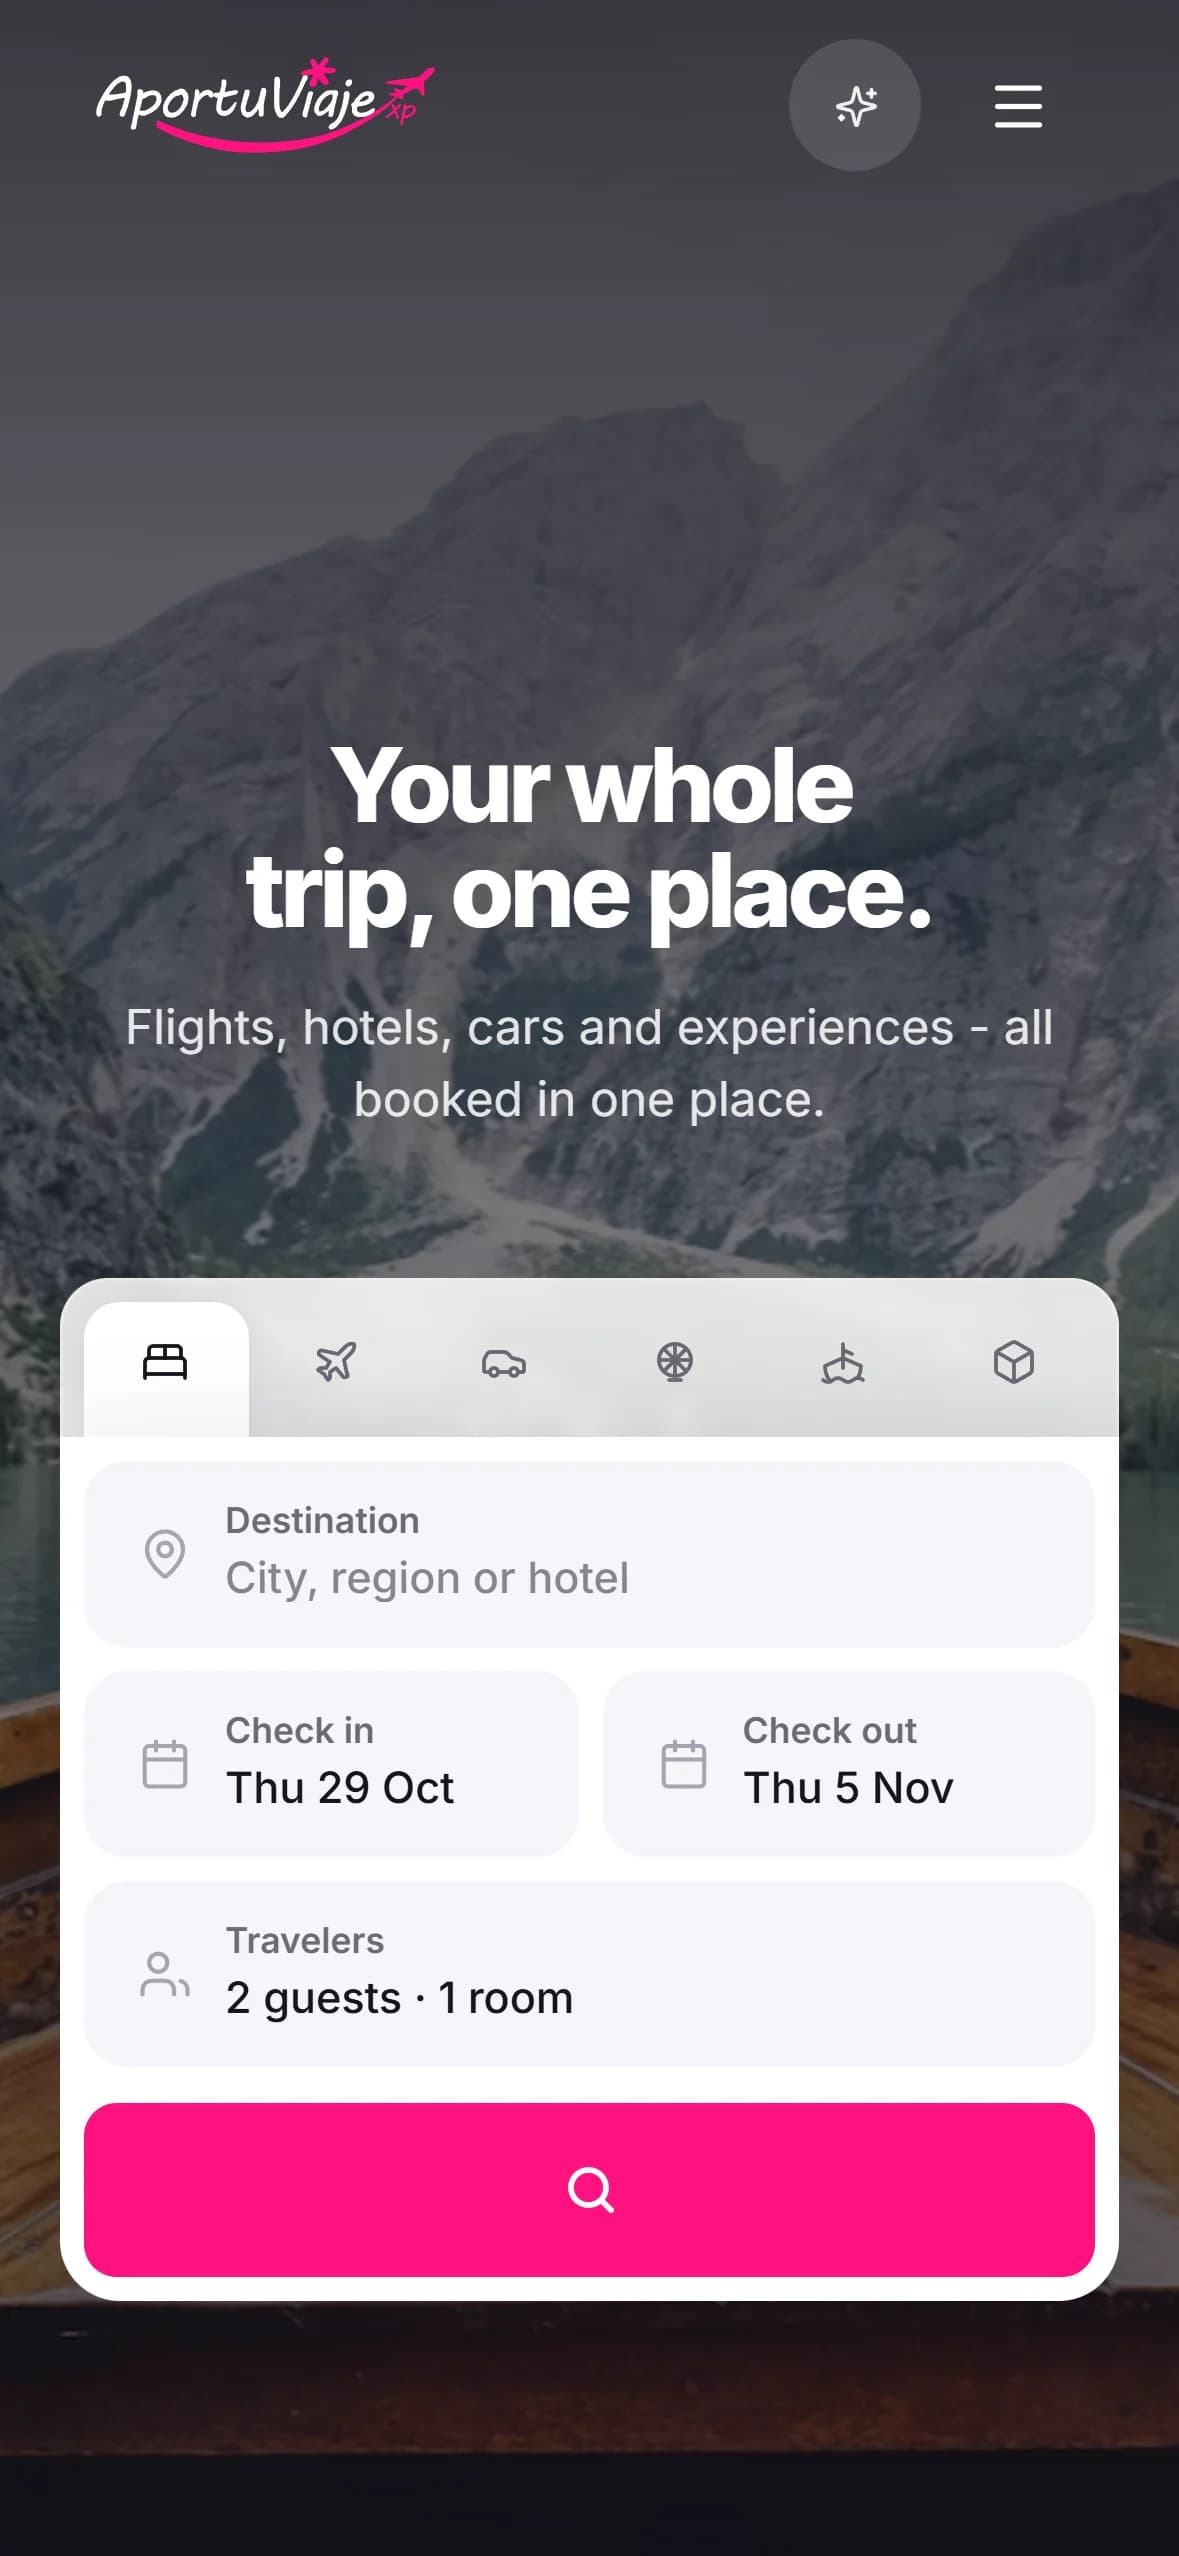
  • Viagens

    Uma app de reservas de viagem cujo assistente de IA encontra voos, hotéis e ideias de viagem, até à reserva confirmada.

  • IA

    Silvia AI

    Um assistente de IA para apoio ao cliente e vendas, que responde a dúvidas e orienta os compradores.

    Captura de ecrã, 1908 × 944

Perguntas sobre LLM privados

O que as equipas perguntam antes de correr um modelo na sua própria infraestrutura, respondido com clareza.

Faça a sua
Quando compensa um LLM privado em vez de uma API de IA?

Quando os seus dados não podem ir para um fornecedor externo, quando o seu volume torna caro pagar por token, ou quando precisa de controlar a velocidade e a disponibilidade. Para um protótipo, ou para o raciocínio mais difícil, uma API alojada é muitas vezes o melhor ponto de partida, e dizemos-lho. Muitas equipas acabam num modelo híbrido: privado para o sensível e o rotineiro, alojado para o resto.

Pode funcionar nos nossos servidores, ou mesmo sem internet?

Sim. Implementamos on-premise, na sua própria conta na cloud ou totalmente isolado. Numa instalação isolada, os modelos, as suas dependências e cada atualização são trazidos sem ligação, e os servidores não têm caminho para fora.

Que modelos abertos usam, e são tão bons como o GPT ou o Claude?

Llama, Qwen, Mistral, Gemma e DeepSeek, entre outros. Os melhores modelos abertos já igualam os alojados em muitas tarefas do dia a dia, e um modelo afinado pode superá-los nas suas, embora não em tudo. Primeiro testamos os candidatos com os seus próprios exemplos, para que veja a diferença antes de decidir.

De que hardware precisamos?

Depende do tamanho do modelo e do seu tráfego. Um modelo pequeno funciona com uma só GPU; um grande precisa de várias, ou de uma versão quantizada que caiba em menos. Dimensionamos o hardware para a sua carga de trabalho antes de comprar o que quer que seja, e podemos trabalhar com servidores que já tenha.

Precisamos de fine-tuning, ou basta o RAG?

Para responder com os seus documentos, o RAG costuma bastar e mantém os dados atualizados. O fine-tuning serve para um formato, um tom ou uma tarefa concreta, e permite que um modelo pequeno faça o trabalho de um maior. Treinar um modelo de raiz raramente compensa; diremos se o seu caso é a exceção.

De que dados precisa o fine-tuning, e para onde vão?

Normalmente, de umas centenas a uns milhares de bons exemplos da tarefa, que ajudamos a reunir e limpar. O treino corre na sua infraestrutura ou na sua conta na cloud, por isso os dados nunca saem dela, e os dados pessoais podem ser removidos antes.

Pode trabalhar com os nossos documentos e sistemas?

Sim. O modelo disponibiliza uma API compatível com a OpenAI, por isso a maioria das ferramentas e do código liga-se tal como está. Por cima construímos RAG privado sobre os seus documentos, assistentes para as suas equipas e agentes de IA que atuam nos seus sistemas.

Como são protegidos os nossos dados?

Prompts, ficheiros e respostas ficam dentro da sua rede. Entra-se com o seu início de sessão único, cada equipa chega só ao que lhe cabe, cada pedido fica registado e a implementação é testada contra injeção de prompts e fugas de dados antes do lançamento.

De quem são o modelo e o código?

Normalmente, seus: num trabalho para um cliente, os pesos afinados, os dados de treino, o código e a configuração são seus conforme o acordo, e funcionam na infraestrutura que controla. As licenças dos modelos abertos variam, e verificamos que cada uma serve o seu uso.

Quanto tempo demora e quanto custa?

Testar modelos com os seus casos e dimensionar o hardware leva uma a duas semanas, uma primeira implementação duas a seis, e o fine-tuning mais umas semanas quando compensa. O custo de funcionamento é sobretudo o hardware ou as GPU na cloud, um custo fixo em vez de uma fatura por token. Depois de uma primeira chamada enviamos uma estimativa por escrito.
Descreva o seu projeto. Damos-lhe um orçamento.