

Retail · SaaS
Un sistema de punto de venta que reúne ventas, inventario y tickets en el terminal, la tableta y el móvil.
Captura de pantalla, 1908 × 944
Chatbots, agentes y RAG atacados como lo haría un atacante real. Cada hallazgo demostrado, corregido y verificado.
Seis pruebas en cada capa de un producto con IA, desde la app con la que habla la gente hasta los datos que lee.
El chat, su prompt de sistema y la app y la API alrededor del modelo.
Hallazgos habituales
El prompt de sistema revelado, datos de otro usuario en una respuesta, un script ejecutado desde la salida del modelo.
Jailbreaks y respuestas dañinas, probados a escala a mano y con baterías de ataques automatizadas.
Hallazgos habituales
Un juego de rol que se salta las reglas, políticas que ceden en un chat largo, respuestas dañinas en otro idioma.
Los filtros de entrada y salida que ya usas, atacados hasta que ceden, reforzados y verificados de nuevo.
Hallazgos habituales
Filtros burlados reformulando, codificando o en otro idioma, controles de salida que no detectan código.
Lo que se puede convencer a un agente de hacer con las herramientas y permisos que tiene.
Hallazgos habituales
Reembolsos y emails enviados desde un chat, herramientas con más acceso del que necesita su tarea, acciones sin confirmación.
Los servidores y APIs a los que llama el modelo, y lo que le confían.
Hallazgos habituales
Herramientas que se fían de los argumentos del modelo, tokens con acceso a toda la cuenta, llamadas sin límite.
Los documentos que lee el asistente, y quién puede recuperar qué.
Hallazgos habituales
Documentos plantados que dirigen las respuestas, archivos de RR. HH. al alcance de cualquiera, un índice en el que escribe cualquiera.
Cinco pasos, desde las funciones de IA que entran en el alcance hasta cada hallazgo corregido y verificado.
Los modelos, agentes, herramientas y fuentes de datos en el alcance, con un modelo de amenazas según el OWASP LLM Top 10.
Todo lo que la IA puede alcanzar, mapeado: prompts, permisos de herramientas, datos recuperados y APIs.
Inyección de prompts, jailbreaks, fugas de datos y abuso de herramientas, automatizados a escala y a mano.
Cada hallazgo con su traza de ataque, su gravedad, su referencia OWASP y su corrección.
Salvaguardas y correcciones construidas, y los mismos ataques repetidos para demostrar que aguantan.
Los riesgos del OWASP Top 10 para aplicaciones LLM, probados contra tu app en vez de leídos en una lista.
Prompt injection
Instrucciones ocultas en chats, documentos y páginas que hacen que el modelo ignore las suyas.
Datos sensibles en las respuestas
Registros de clientes, secretos y datos de otros usuarios sacados a través del modelo.
Datos envenenados
Documentos y datos de entrenamiento plantados para dirigir lo que dice el modelo.
Salida insegura
Respuestas que se ejecutan como código, enlaces o comandos en la app que las muestra.
Demasiada autonomía
Herramientas que actúan con más acceso, o menos confirmación, de lo que pide la tarea.
Fuga del prompt de sistema
Las instrucciones, claves y reglas del asistente leídas por un usuario.
Búsquedas que ignoran los accesos
Índices y embeddings que devuelven documentos que quien pregunta no puede ver.
Uso sin límites
Peticiones que disparan la factura o tiran el servicio, sin un límite que las pare.
Desarrollo de software a medida para cada sector: web, móvil e IA, construido y auditado en seguridad por un mismo equipo.
También desarrollamos software para seguros (insurtech), administración pública (govtech), energía y medios. Si tu sector no aparece, también podemos desarrollar software para él.
Los modelos, frameworks y almacenes de datos sobre los que se construyen los productos con IA, atacados con las herramientas de un pentest web y ataques escritos para IA.
Tres productos propios, construidos, atacados y mantenidos por el equipo que probaría tu IA.
Retail · SaaS
Un sistema de punto de venta que reúne ventas, inventario y tickets en el terminal, la tableta y el móvil.
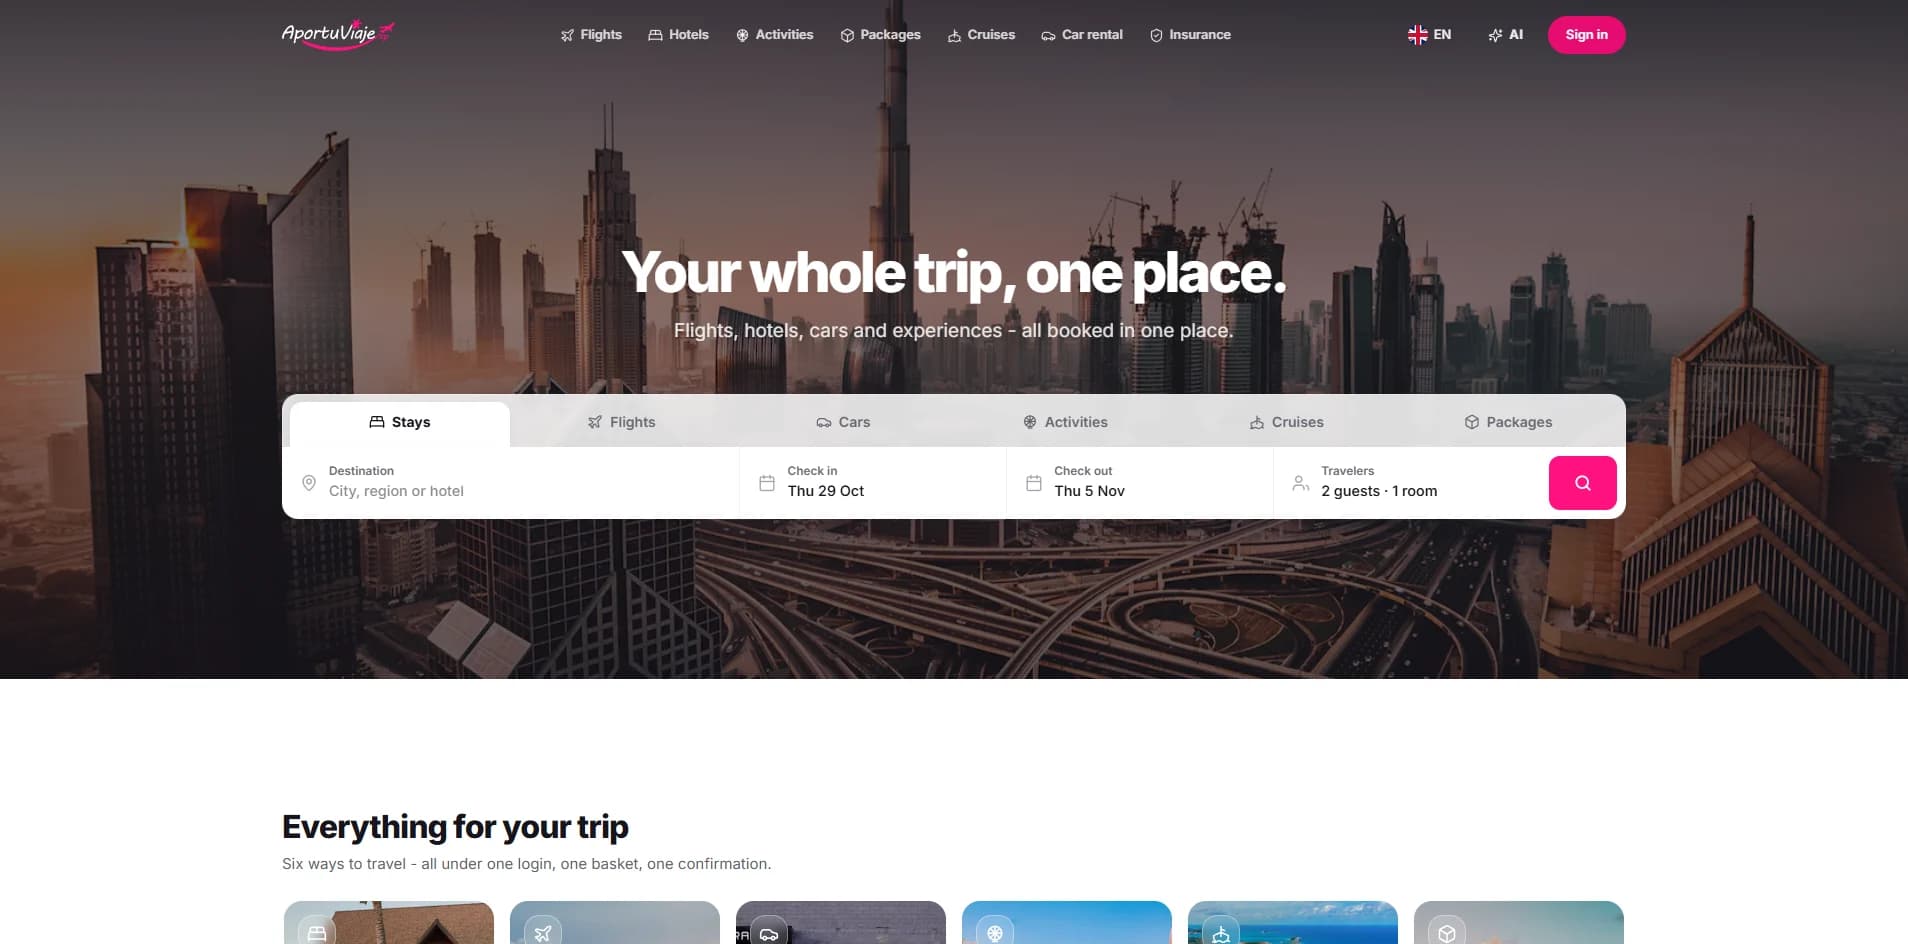
Viajes
Una app de reservas de viaje cuyo asistente de IA encuentra vuelos, hoteles e ideas de viaje, hasta la reserva confirmada.
IA
Un asistente de IA para atención al cliente y ventas, que resuelve dudas y guía a los compradores.
Lo que los equipos preguntan antes de dejar que alguien ataque su IA, respondido con claridad.
Un pentest ataca la app, su inicio de sesión y su API. Una prueba de seguridad de IA añade el modelo: lo que se le puede convencer de decir, los documentos de los que se fía y lo que sus herramientas pueden hacer por un atacante. Probamos las dos cosas juntas, porque la mayoría de los ataques reales a la IA pasan de una a otra.
Es texto que hace que el modelo siga las instrucciones de un atacante en vez de las tuyas, escrito en un chat u oculto en un documento, una página o un email que lee. No se puede quitar del modelo, así que la corrección está alrededor: limitar a qué llega y qué puede hacer, revisar lo que entra y lo que sale, y pedir a una persona que confirme antes de algo sensible.
Sí, y son los que más lo necesitan. Intentamos convencer al agente de usar sus herramientas en tu contra —reembolsos, emails, cambios de registros, servidores MCP— y comprobamos que cada herramienta tiene solo el acceso que pide su tarea y pide confirmación donde debe.
Es atacar el comportamiento del modelo a escala: jailbreaks, respuestas dañinas o fuera de política y reglas que ceden en un chat largo, a mano y con baterías de ataques automatizadas. Un asistente con el que hablan tus clientes lo necesita antes de lanzarse y después de cada cambio de modelo o de prompt.
Permiso por escrito y el alcance, cuentas de prueba para cada rol y una copia de staging si existe. El prompt de sistema, los permisos de las herramientas y cómo funciona la búsqueda hacen la prueba más profunda; también podemos probar desde fuera con solo la app. Antes de nada se firma un NDA.
Las pruebas se hacen en staging si existe. Todo lo que toque producción se acuerda antes en unas reglas de actuación por escrito —horarios, límites de peticiones, qué herramientas pueden ejecutarse de verdad— y una prueba se detiene en la prueba de concepto en vez de hacer daño.
Cada hallazgo con su gravedad, los pasos y la prueba de que se puede explotar y cómo corregirlo, relacionado con el OWASP Top 10 para aplicaciones LLM y MITRE ATLAS. Un resumen para quien decide y el detalle para quien corrige. Es tuyo.
Antes del lanzamiento y cada vez que cambian el modelo, el prompt de sistema, las herramientas o los datos, porque cada cambio puede abrir una nueva vía. Los ataques de una prueba pueden ejecutarse como pruebas en cada cambio, así que la mayoría de las regresiones se detectan antes de publicar.
Depende de lo que entre en el alcance: un chatbot, un agente y sus herramientas, un sistema RAG sobre tus documentos. Tras una primera llamada recibes un presupuesto por escrito con el alcance, el precio y las fechas, antes de empezar ninguna prueba.