LLM locales y privados dentro de tu red

LLM a medida sobre modelos abiertos, ajustados con tus datos y en tus servidores, sin que nada salga de tu red.

LLM privados que desplegamos

Las seis configuraciones que más entregamos, y cualquier otra que pidan tus normas sobre datos.

  1. 01 / 06

    LLM on-premise y aislados

    Modelos abiertos en tus propios servidores, sin ruta a internet cuando tus normas lo exigen.

    • Servidores con GPU dimensionados e instalados en tu centro de datos
    • Instalaciones aisladas, con modelos y actualizaciones traídos sin conexión
    • Sin conexión con servicios de IA externos
    • Tras tu cortafuegos y tu inicio de sesión único
  2. 02 / 06

    LLM en nube privada

    Modelos servidos desde tu propia cuenta en la nube, en la región donde deben quedarse tus datos.

    • En tu propia cuenta y tu red en la nube, no en las nuestras
    • En la región donde deben quedarse tus datos
    • Endpoints privados, sin ruta pública hasta el modelo
    • GPU que suben y bajan con la demanda
  3. 03 / 06

    Híbrido: modelos privados y alojados

    Un modelo privado para el trabajo sensible y de gran volumen, y un modelo alojado de frontera solo para lo que hace mejor.

    • Cada petición enrutada según los datos que lleva
    • Los datos sensibles, siempre en el modelo privado
    • Un modelo alojado para el razonamiento más difícil, donde se permita
    • Una sola API para tus aplicaciones, responda el modelo que responda
  4. 04 / 06

    Modelos ajustados y a medida

    Modelos abiertos adaptados a tus documentos, términos y formatos, y modelos pequeños entrenados para una sola tarea.

    • Fine-tuning con LoRA sobre tus propios ejemplos
    • Modelos pequeños para una tarea, más baratos de mantener
    • Más entrenamiento con tus propios textos cuando compensa
    • Puntuado frente al modelo base antes de publicarse
  5. 05 / 06

    RAG, asistentes y agentes privados

    Búsqueda en documentos, asistentes y agentes de IA construidos sobre el modelo privado, para que tus datos no salgan de tu red en ningún momento.

    • Respuestas con tus documentos, citando sus fuentes
    • Asistentes para equipos legales, de finanzas, RR. HH. y soporte
    • Agentes que actúan en tus sistemas con el modelo privado
    • El mismo inicio de sesión y los mismos permisos que tus herramientas
  6. 06 / 06

    En marcha, vigilado y al día

    El modelo, rápido, asequible y actualizado después del lanzamiento, con cada petición registrada.

    • Rendimiento, latencia y carga de GPU monitorizados
    • Cuantización y procesamiento por lotes ajustados para reducir costes
    • Los nuevos modelos abiertos, probados antes de sustituir a los actuales
    • Registros de uso y de auditoría para cada equipo

Nuestro proceso de desarrollo de LLM privados

Seis pasos, desde lo que el modelo tiene que hacer hasta un modelo que tu equipo usa a diario en tu propio hardware.

  1. 01Alcance

    Tus casos de uso, datos y cumplimiento, y lo que cuesta frente a una API alojada.

  2. 02Planificación

    Modelos abiertos probados con tus casos y uno elegido, con el hardware dimensionado en tus instalaciones o en una nube privada.

  3. 03Desarrollo

    Fine-tuning o recuperación donde compensa, y conectado a tus aplicaciones.

  4. 04Pruebas

    Precisión, latencia y alucinaciones medidas, con los controles de acceso y auditoría comprobados.

  5. 05Lanzamiento

    Servido detrás de tu propia pasarela, con inicio de sesión único y monitorización.

  6. 06Mantenimiento

    Actualizaciones del modelo, parches y guardias, o un traspaso a tu propio equipo.

Funciones de los LLM privados

Lo que integramos en un modelo privado, ajustado a dónde funciona y quién lo usa.

  • Aislamiento de red

    Sin llamadas a servicios de IA externos: prompts, archivos y respuestas se quedan en la infraestructura que controlas.

  • Una API estándar que tus apps ya entienden

    Un endpoint compatible con OpenAI, para que herramientas y código cambien con solo una dirección.

  • Inicio de sesión único y roles

    Se entra con tu inicio de sesión único, y cada equipo llega solo a los modelos y datos que le tocan.

  • Registro de auditoría

    Quién preguntó qué, cuándo y qué modelo respondió, en un registro que es tuyo.

  • Límites de uso por equipo

    Cuotas de peticiones y tokens por equipo o app, para que una carga no deje sin recursos al resto.

  • Ajustado a tu hardware

    Modelos cuantizados y agrupados para caber en tus GPU, sin bajar del listón de calidad.

  • Nuevas comparativas de modelos

    Cada nuevo modelo abierto se puntúa con tus casos, y solo entra si gana.

  • Monitorización y alertas

    Rendimiento, latencia, errores y carga de GPU vigilados, con alertas antes de que lo noten tus usuarios.

  • Pruebas de red team

    Inyección de prompts, fugas de datos y reglas de acceso probadas antes del lanzamiento y tras cada cambio.

Cómo empezar

Algo nuevo con IA, o IA en el software que ya tienes.

Algo nuevo

Software que ya tienes

Sectores para los que desarrollamos software

Desarrollo de software a medida para cada sector: web, móvil e IA, construido y auditado en seguridad por un mismo equipo.

  • Una habitación de hospital moderna al anochecer, con la cama hecha junto a un monitor de paciente y un portasueros

    Salud y MedTech

    Desarrollo de software médico y sanitario: portales de paciente, apps de telemedicina, integración con la historia clínica y paneles clínicos.

  • Un móvil con una app de banca abierta junto a una tarjeta de pago metálica negra sobre una mesa de piedra

    Fintech y pagos

    Desarrollo de apps fintech y de pagos: pasarelas de pago, monederos digitales, banca móvil y plataformas de préstamos.

  • Una tienda de streetwear con una pared de sudaderas y camisetas deportivas, un muro iluminado de zapatillas y un expositor de terrazo con camisetas y gorras

    Retail y ecommerce

    Desarrollo de tiendas online y ecommerce: apps de compra, software TPV y gestión de inventario.

  • Un carro portaequipajes de latón con maletas y un abrigo en el vestíbulo de un hotel moderno, junto a la recepción

    Viajes y hostelería

    Software de viajes y hostelería: apps de viajes, motores de reservas, gestión hotelera e integración con proveedores.

  • Una línea de montaje robotizada en una fábrica inteligente, con brazos robóticos en celdas de cristal y robots autónomos que transportan piezas

    IA y automatización

    Desarrollo de IA y automatización: agentes de IA, chatbots, procesamiento de documentos y flujos de trabajo automatizados.

  • El estudio de un equipo de software, con una hoja de ruta de notas adhesivas en una pizarra sobre una mesa compartida

    SaaS y marketplaces

    Desarrollo de software SaaS y marketplaces: plataformas multiempresa, suscripciones, roles de usuario y pagos a vendedores.

  • Paquetes en una cinta transportadora de un almacén de distribución, con estanterías altas de palés y una carretilla elevadora detrás

    Logística y cadena de suministro

    Software de logística y transporte: gestión de flotas, sistemas de gestión de almacenes, planificación de rutas y seguimiento de envíos.

  • El atrio de una biblioteca universitaria con mesas de estudio, salas de estudio acristaladas y una sala de grabación bajo varias plantas de estanterías

    Educación y EdTech

    Desarrollo de plataformas educativas y EdTech: sistemas LMS, plataformas e-learning, aulas virtuales y evaluaciones.

  • Una puerta de cristal con lector de huellas junto a un largo pasillo de racks de servidores en un centro de datos

    Ciberseguridad

    Software de ciberseguridad: gestión de identidades y accesos, paneles SIEM y cumplimiento, además de auditorías de seguridad y pentesting.

  • El salón y la cocina de un piso de obra nueva al anochecer, con ventanales de suelo a techo hacia torres residenciales y una grúa torre

    Inmobiliario y PropTech

    Software inmobiliario y PropTech: portales inmobiliarios, CRM inmobiliario, gestión de alquileres y apps para inquilinos.

  • La biblioteca de doble altura de un despacho de abogados al anochecer, con una larga mesa de nogal preparada con un contrato, una pluma y archivadores

    Legal y LegalTech

    Software legal para despachos y equipos jurídicos: gestión de expedientes y contratos, gestión documental y eDiscovery.

  • Un estadio de esports antes de una final, un mapa de batalla de fantasía en la pantalla gigante sobre dos mesas de equipo iluminadas y una copa de plata en un pedestal

    Gaming y esports

    Software para esports y gaming: backends de juegos, emparejamiento multijugador, plataformas de torneos, cuentas de jugador y pagos dentro del juego.

También desarrollamos software para seguros (insurtech), administración pública (govtech), energía y medios. Si tu sector no aparece, también podemos desarrollar software para él.

Software que tenemos en producción

Tres productos propios, diseñados, construidos y mantenidos por el equipo que desplegaría tu LLM privado.

  • Retail · SaaS

    Un sistema de punto de venta que reúne ventas, inventario y tickets en el terminal, la tableta y el móvil.

    Captura de pantalla, 1908 × 944
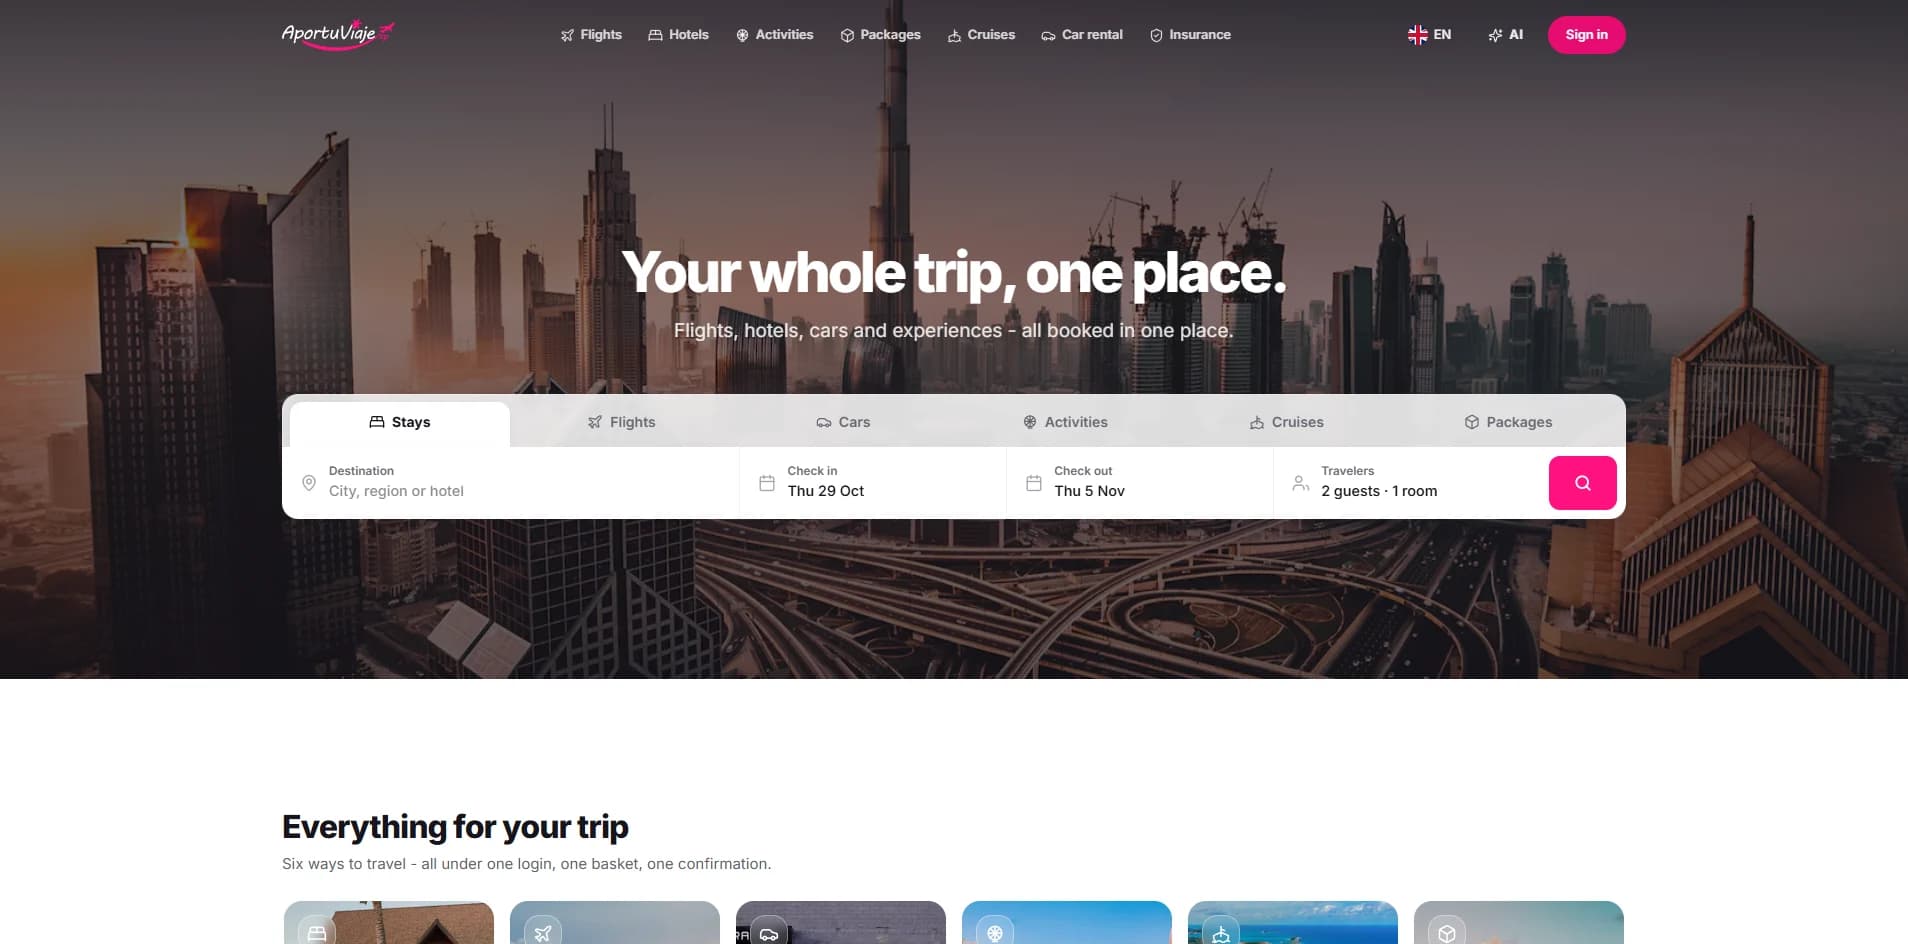
  • Viajes

    Una app de reservas de viaje cuyo asistente de IA encuentra vuelos, hoteles e ideas de viaje, hasta la reserva confirmada.

  • IA

    Silvia AI

    Un asistente de IA para atención al cliente y ventas, que resuelve dudas y guía a los compradores.

    Captura de pantalla, 1908 × 944

Preguntas sobre LLM privados

Lo que los equipos preguntan antes de ejecutar un modelo en su propia infraestructura, respondido con claridad.

Haz la tuya
¿Cuándo compensa un LLM privado frente a una API de IA?

Cuando tus datos no pueden ir a un proveedor externo, cuando tu volumen encarece el pago por token o cuando necesitas controlar la velocidad y la disponibilidad. Para un prototipo, o para el razonamiento más difícil, una API alojada suele ser mejor punto de partida, y te lo decimos. Muchos equipos acaban en un modelo híbrido: privado para lo sensible y lo rutinario, alojado para el resto.

¿Puede funcionar en nuestros servidores, o incluso sin internet?

Sí. Desplegamos on-premise, en tu propia cuenta en la nube o totalmente aislado. En una instalación aislada, los modelos, sus dependencias y cada actualización se traen sin conexión, y los servidores no tienen ruta hacia fuera.

¿Qué modelos abiertos usáis, y son tan buenos como GPT o Claude?

Llama, Qwen, Mistral, Gemma y DeepSeek, entre otros. Los mejores modelos abiertos ya igualan a los alojados en muchas tareas del día a día, y un modelo ajustado puede superarlos en las tuyas, aunque no en todo. Primero probamos los candidatos con tus propios ejemplos, para que veas la diferencia antes de decidir.

¿Qué hardware necesitamos?

Depende del tamaño del modelo y de tu tráfico. Un modelo pequeño funciona con una sola GPU; uno grande necesita varias, o una versión cuantizada que quepa en menos. Dimensionamos el hardware para tu carga de trabajo antes de comprar nada, y podemos trabajar con servidores que ya tengas.

¿Necesitamos fine-tuning, o basta con RAG?

Para responder con tus documentos, RAG suele bastar y mantiene los datos al día. El fine-tuning sirve para un formato, un tono o una tarea concreta, y permite que un modelo pequeño haga el trabajo de uno mayor. Entrenar un modelo desde cero rara vez compensa; te diremos si tu caso es la excepción.

¿Qué datos necesita el fine-tuning, y adónde van?

Normalmente, de unos cientos a unos miles de buenos ejemplos de la tarea, que te ayudamos a reunir y limpiar. El entrenamiento se hace en tu infraestructura o en tu cuenta en la nube, así que los datos nunca salen de ella, y los datos personales pueden eliminarse antes.

¿Puede trabajar con nuestros documentos y sistemas?

Sí. El modelo ofrece una API compatible con OpenAI, así que la mayoría de herramientas y código se conectan tal cual. Encima construimos RAG privado sobre tus documentos, asistentes para tus equipos y agentes de IA que actúan en tus sistemas.

¿Cómo se protegen nuestros datos?

Prompts, archivos y respuestas se quedan dentro de tu red. Se entra con tu inicio de sesión único, cada equipo llega solo a lo que le corresponde, cada petición queda registrada y el despliegue se prueba frente a inyección de prompts y fugas de datos antes del lanzamiento.

¿De quién son el modelo y el código?

Normalmente, tuyos: en un trabajo para un cliente, los pesos ajustados, los datos de entrenamiento, el código y la configuración son tuyos según lo que fije el acuerdo, y funcionan en la infraestructura que controlas. Las licencias de los modelos abiertos varían, y comprobamos que cada una encaja con tu uso.

¿Cuánto se tarda y cuánto cuesta?

Probar modelos con tus casos y dimensionar el hardware lleva de una a dos semanas, un primer despliegue de dos a seis, y el fine-tuning unas semanas más cuando compensa. El coste de funcionamiento es sobre todo el hardware o las GPU en la nube, un coste fijo en lugar de una factura por token. Tras una primera llamada te enviamos un presupuesto por escrito.
Describe tu proyecto. Te damos un presupuesto.